Qu’est-ce que l’apprentissage fédéré ?
L’apprentissage fédéré entraîne un modèle commun sur des données qui restent sur les appareils qui les détiennent : seules les mises à jour du modèle circulent. Ce que c’est, et quand c’est utile.
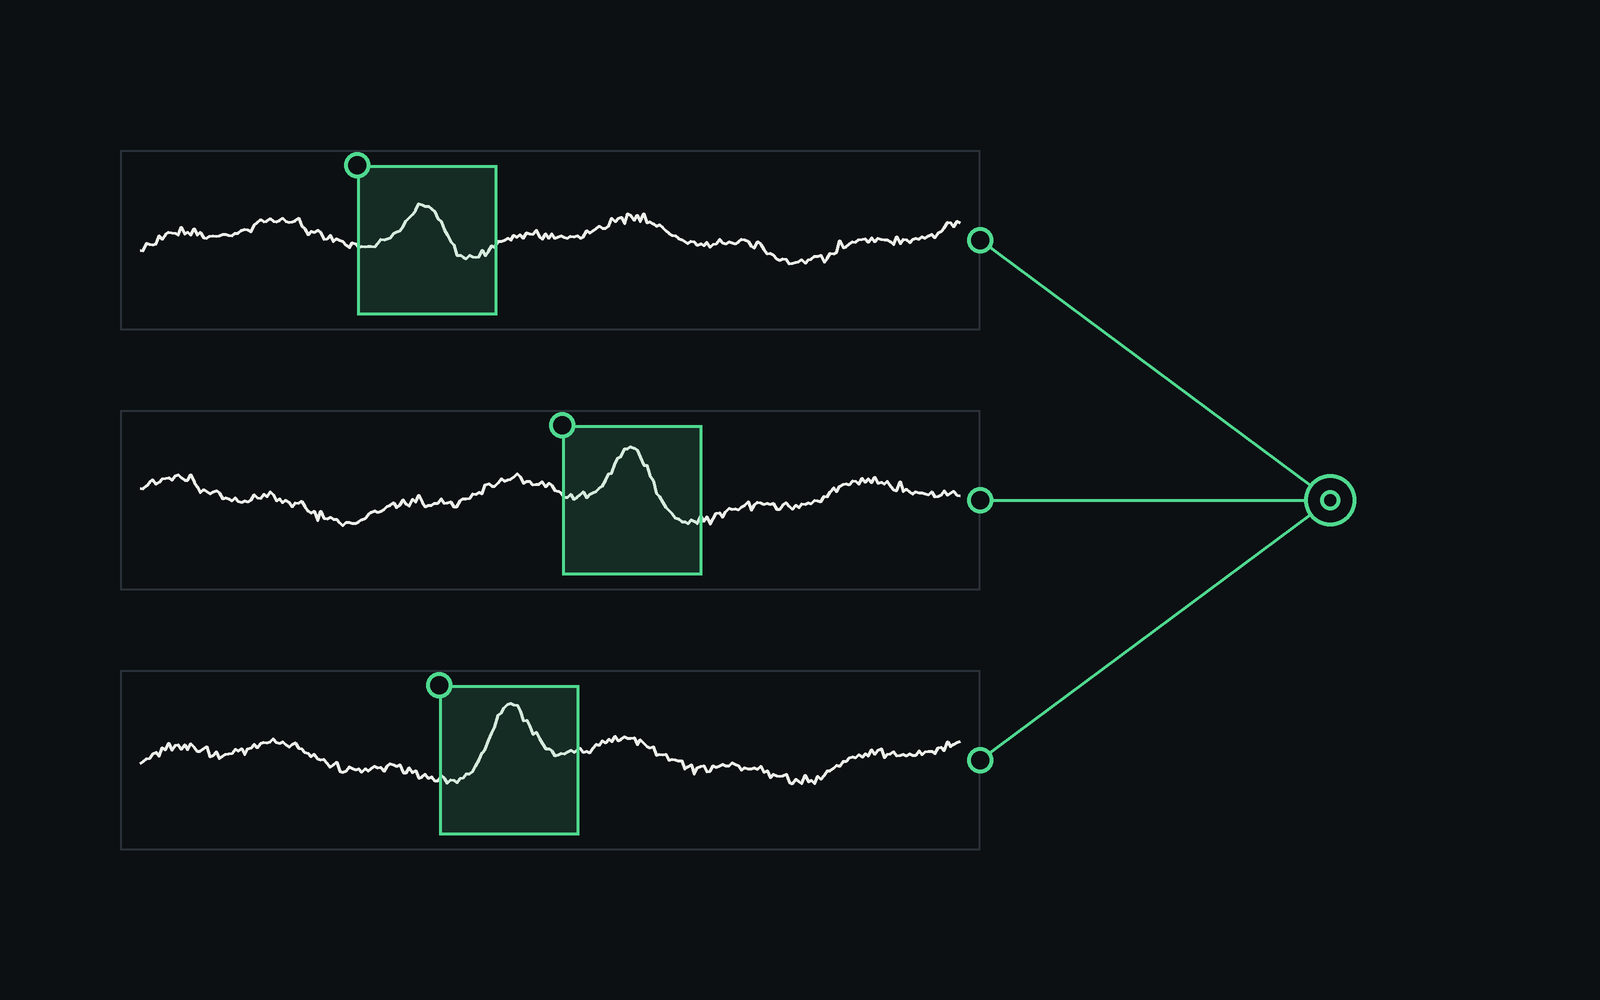
L’apprentissage fédéré entraîne un seul modèle sur des données réparties en plusieurs lieux sans déplacer les données : chaque site entraîne sur ce qu’il détient et n’envoie que les mises à jour du modèle à un coordinateur, qui en fait la moyenne. Il répond à une question, comment apprendre de données qui ne peuvent pas quitter leur site, et laisse les autres ouvertes : les labels restent à faire sur chaque site, et les mises à jour elles-mêmes sont à protéger.
D’où il vient
La méthode a été nommée et formalisée par McMahan et al. (2017) chez Google, pour entraîner les modèles de clavier des téléphones sans téléverser ce que les gens tapent. Leur algorithme, la moyenne fédérée, reste la référence : un coordinateur envoie le modèle courant à un ensemble de participants, chacun l’entraîne quelques passes sur ses propres données, chacun renvoie ses nouveaux poids, et le coordinateur remplace le modèle par la moyenne pondérée de ce qu’il a reçu. Un tel échange est un tour ; un entraînement en compte de quelques centaines à quelques milliers. Une synthèse de Kairouz et al. (2021), signée par 58 auteurs de 25 institutions, dresse la liste des problèmes ouverts que les quatre premières années avaient soulevés.
Deux familles
| Entre appareils | Entre organisations | |
|---|---|---|
| Participants | Des millions de téléphones ou de capteurs, peu disponibles à la fois | Une poignée d’organisations ou de sites, tous disponibles |
| Données par participant | Peu | Beaucoup, souvent des années d’enregistrements |
| Fiabilité | Des participants décrochent en cours de tour | Les participants restent jusqu’au bout |
| Exemple | Prédiction du mot suivant sur un clavier | Hôpitaux, banques, ou sites d’un même programme qui gardent chacun leurs enregistrements |
La distinction est celle de Kairouz et al. Le cas entre organisations est celui qui concerne le travail sur les signaux : quelques sites, chacun avec une grande archive qu’on ne peut pas copier, et entre eux un réseau parfois lent ou intermittent.
Ce qu’il ne résout pas
- Les labels. Un modèle supervisé a besoin d’exemples labélisés sur chaque site, faits avec la même taxonomie et les mêmes règles. L’apprentissage fédéré déplace l’entraînement, pas l’annotation.
- Les fuites par les mises à jour. Les poids d’un modèle sont calculés à partir des données et peuvent en révéler une part. L’agrégation sécurisée (Bonawitz et al., 2017) ne laisse voir au coordinateur que la somme des mises à jour, jamais celle d’un participant ; la confidentialité différentielle borne ce qu’un seul enregistrement peut changer. Les deux coûtent en précision ou en tours.
- Des données hétérogènes. Les sites enregistrent avec des capteurs différents, dans des environnements différents, à des fréquences d’échantillonnage différentes. La moyenne fédérée suppose des sites semblables ; quand ils ne le sont pas, le modèle dérive vers le plus gros site ou converge lentement. Adapter un réseau à chaque porteur est un problème en soi, celui qu’Ezako et XPERT ont pris en 2025 pour les plateformes sous-marines.
- Les réseaux isolés. Un site sans aucune connexion ne peut pas prendre part aux tours. L’alternative simple fonctionne : entraîner sur le site, y valider, et transporter le modèle, pas les données.
Quand c’est le bon outil
L’apprentissage fédéré vaut sa complexité quand trois conditions tiennent à la fois : plusieurs sites détiennent des données de même nature, aucun ne peut les communiquer, et un modèle entraîné sur un seul site est mesurablement moins bon qu’un modèle entraîné sur tous. Quand seules les deux premières tiennent, un modèle entraîné et validé sur chaque site, puis comparé, est plus simple et plus facile à auditer. Quand la troisième tient mais que les sites peuvent partager un jeu de données sous accord, un jeu central en versions immuables donne un modèle traçable et un jeu de test que tout le monde peut lire.
Les logiciels d’Ezako sont conçus pour le cas où les données restent où elles sont. Upalgo Labeling et UpalgoDB s’exécutent sur l’infrastructure du client, y compris sur des réseaux isolés ; les modèles sont entraînés sur les jeux de données du client et intégrés à UpalgoDB sur place ; aucune donnée n’est transmise à Ezako. La sécurité et les principes d’ingénierie décrivent comment.
Sources
- H. B. McMahan, E. Moore, D. Ramage, S. Hampson, B. Agüera y Arcas, Communication-Efficient Learning of Deep Networks from Decentralized Data, AISTATS, 2017.
- P. Kairouz et al., Advances and Open Problems in Federated Learning, Foundations and Trends in Machine Learning 14(1-2), 2021.
- K. Bonawitz et al., Practical Secure Aggregation for Privacy-Preserving Machine Learning, ACM CCS, 2017.
- Ezako, Ezako et XPERT : le deep learning de toutes les plateformes sous-marines, 2025.
Publié en janvier 2022 ; réécrit en septembre 2026 avec l’origine de la méthode, les deux familles, ce qu’elle laisse sans réponse et quand elle vaut la peine.