Qu’est-ce que la détection d’anomalies supervisée ?
La détection d’anomalies supervisée entraîne un modèle sur des données labélisées, là où les méthodes non supervisées cherchent seules : comment elle fonctionne, et ce qu’elle demande.
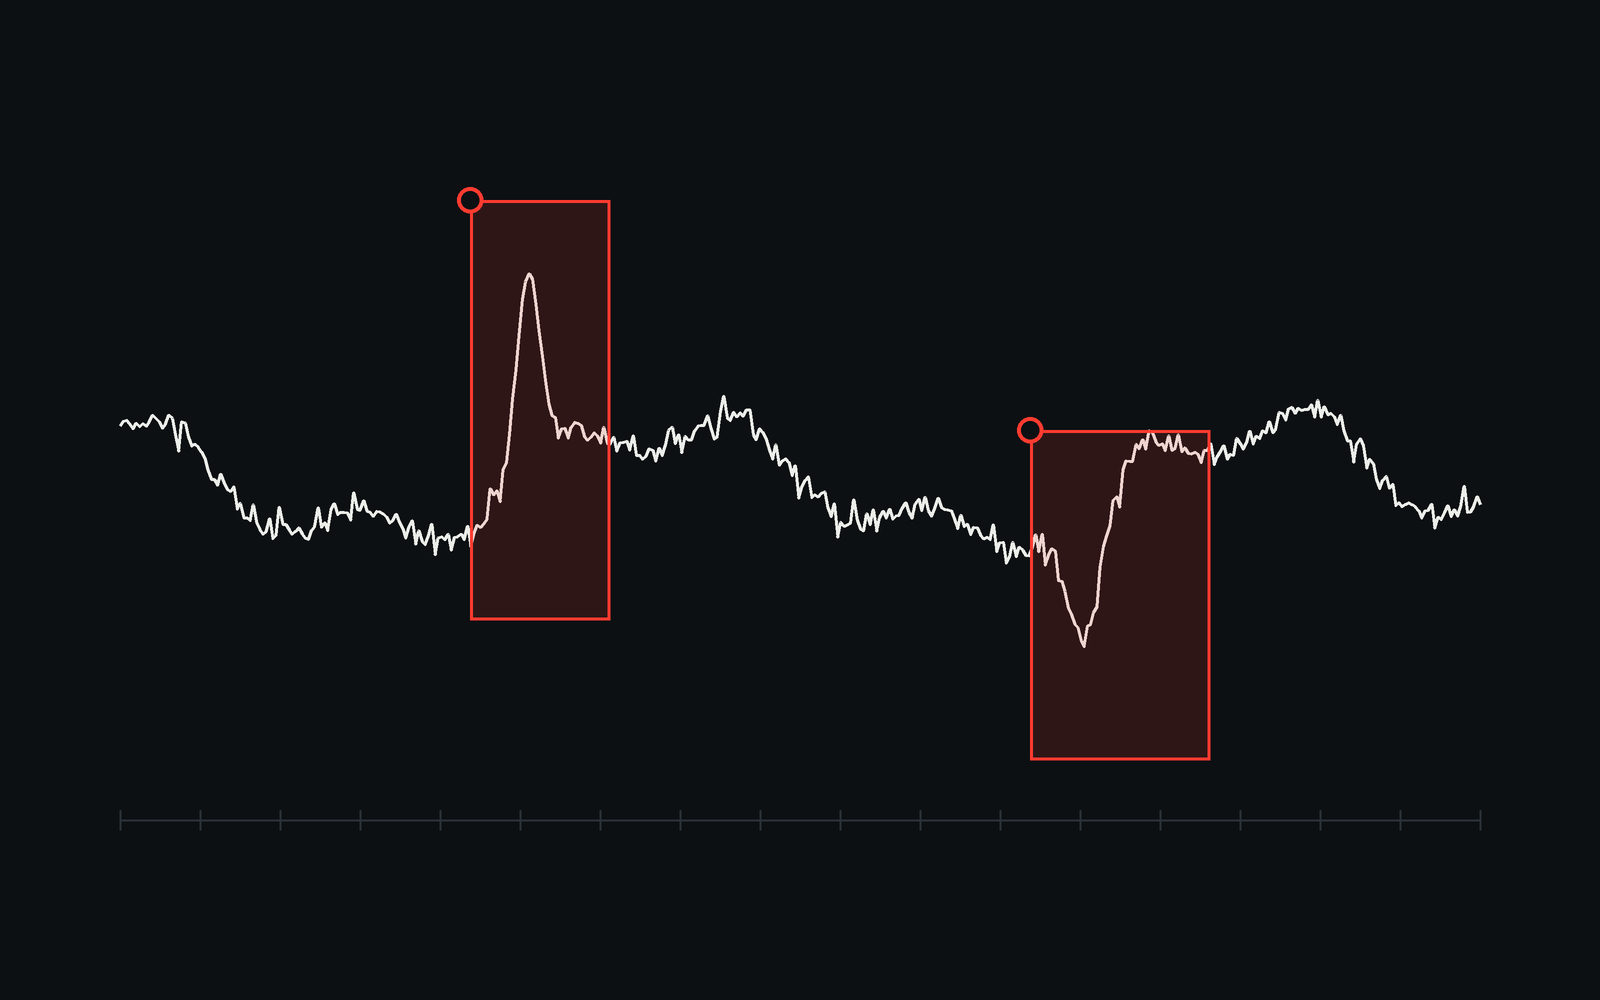
La détection d’anomalies supervisée entraîne un modèle sur des enregistrements où des spécialistes ont déjà marqué quels évènements sont normaux et lesquels ne le sont pas, puis lui fait retrouver les mêmes sortes d’évènements dans des données nouvelles. C’est le plus précis des trois cadres de la détection d’anomalies, et le plus exigeant : il demande un jeu de données labélisé, construit et relu avant tout entraînement.
Trois cadres, une question
L’article de référence du domaine (Chandola, Banerjee et Kumar, 2009) distingue les méthodes selon ce que les données d’entraînement disent de chaque observation.
| Cadre | Ce que disent les labels | Ce que trouve le modèle | Méthodes courantes |
|---|---|---|---|
| Supervisé | Normal ou anormal, sur chaque exemple d’entraînement | Les sortes d’anomalies qu’on lui a montrées | Classifieurs : arbres boostés, réseaux convolutifs sur spectrogrammes, réseaux récurrents sur séries |
| Semi-supervisé | Le normal seulement | Tout ce qui s’écarte du normal appris | SVM à une classe (Schölkopf et al., 2001), auto-encodeurs |
| Non supervisé | Rien | Ce qui est rare ou isolé dans les données | Isolation Forest (Liu, Ting et Zhou, 2008), partitionnement, distance aux voisins |
Les trois ne sont pas concurrents. Une méthode non supervisée est ce qu’une équipe passe sur une archive dont elle ne sait rien ; une méthode semi-supervisée, ce qu’elle met sur une machine dont les pannes ne sont pas encore survenues ; une méthode supervisée, ce qu’elle construit une fois que les analystes ont nommé les évènements qui comptent et en ont marqué assez.
Ce que cela demande
Un détecteur supervisé vaut ce que valent ses labels. Quatre choses décident du résultat avant tout entraînement.
- Une taxonomie. Les évènements sont nommés avant d’être marqués : un passage de navire, un sifflement, une dérive de capteur, un artefact de banc d’essai. Deux analystes qui labélisent le même enregistrement doivent produire les mêmes labels ; la relecture entre eux fait partie du jeu de données.
- Des positifs rares. Les anomalies sont rares par définition, donc le jeu d’entraînement est déséquilibré. Les remèdes sont connus : rééquilibrer les classes, pondérer la fonction de coût, et surtout juger le modèle sur la précision et le rappel plutôt que sur l’exactitude. Sur un jeu où 1 évènement sur 1 000 est anormal, un modèle qui ne signale rien est exact à 99,9 % et ne sert à rien.
- La bonne courbe. Quand les positifs sont rares, la courbe précision-rappel en dit plus que la courbe ROC, qui reste flatteuse à mesure que les négatifs s’accumulent (Saito et Rehmsmeier, 2015). Sur un flux continu, le point de fonctionnement se lit en fausses alarmes par heure à un rappel donné.
- Un jeu de données figé. Les partitions d’entraînement, de validation et de test sont fixées une fois, stratifiées par classe ou découpées par blocs de temps, pour qu’un modèle ne soit jamais testé sur les voisins de ce qu’il a appris. Chaque version est immuable : un modèle reste traçable aux données exactes qu’il a vues.
Comment cela se déroule, étape par étape
- Des spécialistes labélisent un premier échantillon d’enregistrements selon la taxonomie, un relecteur vérifiant chaque fichier.
- Les labels sont répartis en jeux d’entraînement, de validation et de test, et un jeu de réserve est mis de côté.
- Un modèle est entraîné sur le jeu d’entraînement et son point de fonctionnement est choisi sur le jeu de validation : le seuil qui donne la précision que l’exploitation exige.
- Le jeu de test donne les chiffres qui seront cités : précision, rappel et fausses alarmes par heure à ce seuil.
- En service, le modèle propose et un analyste décide. Chaque détection est validée ou rejetée, et chaque décision devient un nouveau label.
- Le jeu de données est versionné à nouveau avec les nouveaux labels, et le modèle réentraîné : cette boucle est ce qui fait progresser le détecteur sur les données du client.
Où Ezako l’applique
Ezako a travaillé dans ce cadre sur plusieurs sortes de signaux. En 2020, le CNES lui a confié la détection d’anomalies dans la télémesure de satellites, à côté des méthodes de surveillance classiques. La même année, pour l’ANFR, elle a prédit les sites radio les plus susceptibles de révéler une anomalie, pour ordonner les contrôles d’un parc national de plus de 76 000 sites. En 2021, avec Safran Aircraft Engines, elle a publié une approche par apprentissage profond des observations anormales dans les séries de capteurs à haute fréquence des essais de développement de moteurs. En 2023, au sein du projet DeepGreen piloté par le CEA, elle a travaillé sur la détection de défauts par apprentissage automatique sur un microcontrôleur.
L’outillage suit la méthode. Dans Upalgo Labeling Timeseries, un analyste marque un évènement sur une série, cherche dans les autres séries les plages qui lui ressemblent et relit chaque candidat avant qu’il reçoive un label ; les motifs rares d’une colonne sont proposés comme candidats. UpalgoDB conserve les labels, construit les jeux de données partitionnés en versions immuables et exécute les détecteurs sur l’infrastructure du client, hors ligne. Les algorithmes, les jeux de données et le service de labélisation décrivent ce qui est disponible.
Sources
- V. Chandola, A. Banerjee, V. Kumar, Anomaly Detection: A Survey, ACM Computing Surveys 41(3), 2009.
- T. Saito, M. Rehmsmeier, The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets, PLOS ONE 10(3), 2015.
- F. T. Liu, K. M. Ting, Z.-H. Zhou, Isolation Forest, IEEE ICDM, 2008.
- B. Schölkopf et al., Estimating the Support of a High-Dimensional Distribution, Neural Computation 13(7), 2001.
- Ezako, Une approche par apprentissage profond de la détection d’anomalies de signal, avec Safran Aircraft Engines, 2021 ; projets.
Publié en décembre 2020 ; réécrit en septembre 2026 avec les trois cadres, les mesures adaptées aux évènements rares, les étapes d’un projet supervisé et les projets menés depuis.